Trilha 003
Metaestabilidade em Sistemas Distribuídos
Decidi abordar um conceito um pouco mais complexo e do "mundo real" na edição dessa semana.
Falhas metastáveis em sistemas distribuídos referem-se a um tipo específico de erro ou modo de falha que pode ocorrer quando múltiplos componentes ou nós em um sistema distribuído estão se comunicando entre si. Essas falhas são caracterizadas pelo fato de serem intermitentes e difíceis de prever, tornando-as particularmente desafiadoras de lidar e diagnosticar.
Então, como um sistema "saudável" pode falhar? Naturalmente, algo precisa acontecer para que ocorra uma falha. Chamamos esse algo de gatilho. Muitas coisas podem atuar como um gatilho (garbage collector, interrupções de rede, implantações de software, mudanças de configuração, picos de carga, etc.).
Gatilhos causam atrasos ou erros e tornam o sistema temporariamente menos eficiente. Em alguns casos, no entanto, eles fazem o sistema entrar em uma espiral e praticamente interromper qualquer trabalho útil ou throughput. Quando o gatilho é removido (se foi transitório ou removido pelos engenheiros), o sistema não se recupera por si só. Assim, acabamos em uma situação peculiar em que a condição que causou uma falha não está mais presente, todos os componentes do sistema parecem estar funcionando corretamente, todos os servidores/nós estão ativos, o código está funcionando, mas nada útil está de fato sendo feito e o throughput permanece insignificante.
Chamamos esse padrão de falha de falha metaestável, ou melhor, dizemos que um sistema entrou em um estado de falha metaestável. O culpado por trás das falhas metaestáveis é um efeito de sustentação que impede o sistema de sair de um estado ruim/fracassado mesmo após a remoção do gatilho inicial.
Para entender mais sobre a importância dos gatilhos e efeitos de sustentação, precisamos observar como a maioria dos sistemas distribuídos é implantada. A utilização de recursos é um fator importante para sistemas grandes, pois melhorar a utilização pode economizar muito dinheiro em escala. Isso significa que os sistemas muitas vezes têm recursos extras limitados quando ocorre um aumento de carga inesperado. Esses sistemas operam em um estado metaestável que chamamos de estado vulnerável metastável, já que o sistema é vulnerável a uma falha se um número suficiente de gatilhos perturbar sua estabilidade.
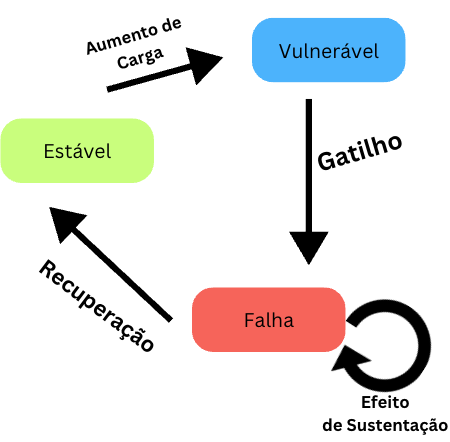
Claro, ter alguma carga extra não antecipada aplicada ao sistema não é suficiente para que ocorra uma falha metastável. Na verdade, mesmo se a carga levar o sistema a funcionar em sua capacidade máxima (ou tentar funcionar acima da capacidade), deveríamos ver apenas um aumento na latência e talvez uma degradação no throughput. Quando a carga extra é removida, o sistema deve retornar ao funcionamento normal por si só.
Na falha metaestável, a carga extra não antecipada ativa um ciclo de feedback positivo que gera mais carga. Este ciclo de feedback positivo é o efeito de sustentação que impede o sistema de se recuperar quando o gatilho inicial é resolvido. Dizemos que um sistema está em um estado vulnerável metastável quando é possível ativar tal ciclo de feedback positivo usando um gatilho forte o suficiente. Esse estado geralmente ocorre em um nível de utilização mais elevado do sistema, uma vez que o sistema possui menos recursos sobressalentes para absorver a carga extra do gatilho sem ativar o mecanismo de feedback positivo. O oposto do estado vulnerável metastável é um estado estável, onde o ciclo de feedback positivo não é possível, permitindo que o sistema se recupere por si só quando a carga extra é removida. Observe que um sistema em um estado estável ainda pode ter um mecanismo de feedback positivo, mas não é forte o suficiente para se alimentar a si mesmo e diminui ao longo do tempo quando a carga extra é removida.
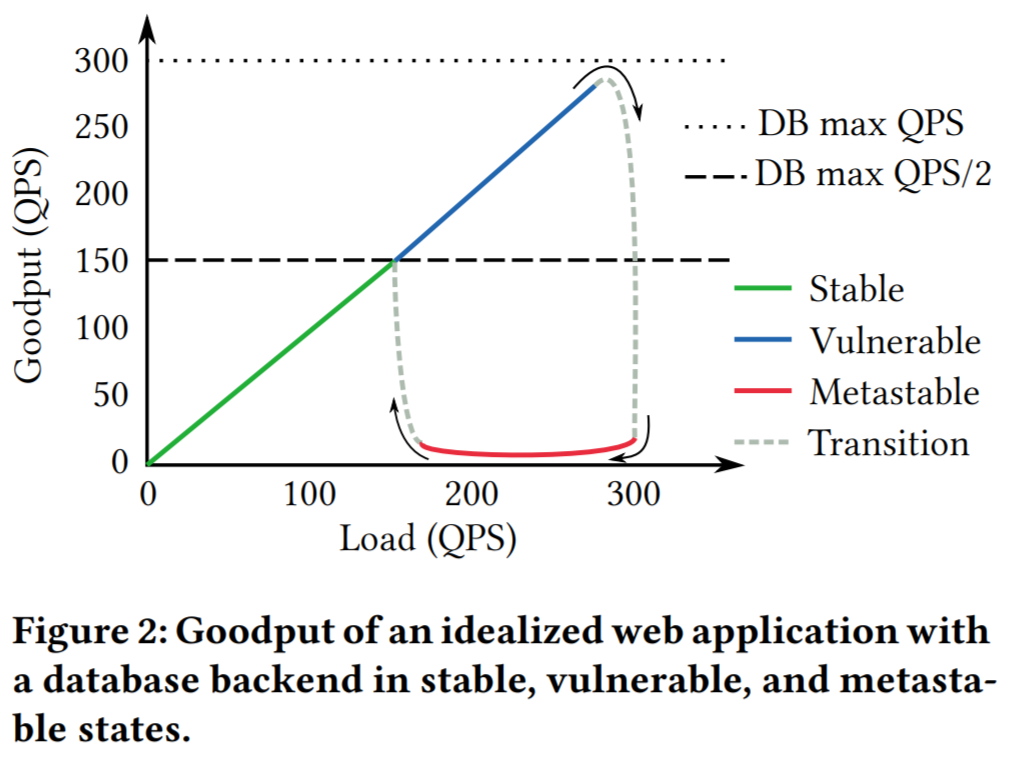
Vamos analisar um exemplo hipotético idealizado de uma falha metastável. Considere uma aplicação web que utiliza um banco de dados capaz de atender até 300 consultas por segundo (Queries por Segundo ou QPS). Se forem feitas mais de 300 QPS, a latência aumenta em uma ordem de magnitude, fazendo com que a aplicação web tente novamente após um timeout de 1 segundo (quando uma nova tentativa falha, o sistema apresenta erro). Os servidores web da aplicação produzem uma carga de trabalho de 280 QPS, o que fica bem abaixo da capacidade de atendimento do banco de dados.
Agora, digamos que ocorreu uma falha de rede que durou alguns segundos entre os servidores web e o banco de dados. Após a correção da rede, todos os pacotes atrasados chegam ao banco de dados de maneira intensa, excedendo a capacidade de 300 QPS do banco de dados. Isso, por sua vez, aumenta a latência acima do limite de tentativas na aplicação web, fazendo com que todas as novas consultas após a falha da rede também tentem novamente. Agora temos um acúmulo de consultas da falha de rede e uma nova carga efetiva de consultas de 560 QPS (280 consultas da carga de trabalho + 280 novas tentativas de consulta). Com uma carga tão alta e sustentada, o banco de dados não voltará ao estado normal por si só. Isso resulta em um sistema sobrecarregado que remove 300 QPS de carga (menos do que a carga ampliada) e produz muito pouco throughput, uma vez que a maioria das consultas demora demais para processar e expira ou é descartada pelo tempo que o banco de dados as retorna. Isso pode continuar indefinidamente até que a carga oferecida seja reduzida para menos de 150 QPS ou a política de novas tentativas seja alterada/suspensa.
Esse artigo é uma tradução de: https://sigops.org/s/conferences/hotos/2021/papers/hotos21-s11-bronson.pdf
Dica de Livro: O Programador Pragmático

O Programador Pragmático ilustra as melhores práticas e as principais armadilhas do desenvolvimento de software. Destinado a todos envolvidos com programação, de codificadores iniciantes a programadores experientes e gerentes responsáveis por projetos de software, apresenta lições simples que promovem rápidas melhorias na produtividade pessoal, precisão e satisfação profissional.
Notas do Editor
Estou tentando abordar assuntos mais complexos, pra quem acompanha a Trilha Info ter uma ideia do que se estuda ou se lida no dia a dia de grandes empresas e sistemas complexos. Espero que estejam gostando.
Um abraço,
.
.
.